
Inventory

Migration des données de stocks : importer des articles sans doublons
Restaurant inventory data migration item import review dashboard

Faites correspondre vos articles existants sans réimporter les doublons

Pour migrer votre référentiel d'articles sans doublons, faites correspondre chaque ligne héritée à un article qui existe déjà, plutôt que de réimporter l'intégralité du fichier. Faites correspondre d'abord sur le code article, puis liez le conditionnement fournisseur à l'article de base auquel il appartient. Ne créez un nouvel article que lorsqu'aucune correspondance n'est trouvée. Une deuxième importation en masse des lignes que vous pensez manquantes est ce qui crée les doublons.

Le modèle un-article-de-base est ce qui rend cela possible. Chaque ingrédient est un seul article de base, et toutes ses références fournisseur et tailles de conditionnement sont liées à cet unique enregistrement. La vraie tâche n'est donc pas d'importer 1 500 lignes. C'est de décider, ligne par ligne, à quel article de base existant chaque ligne appartient.
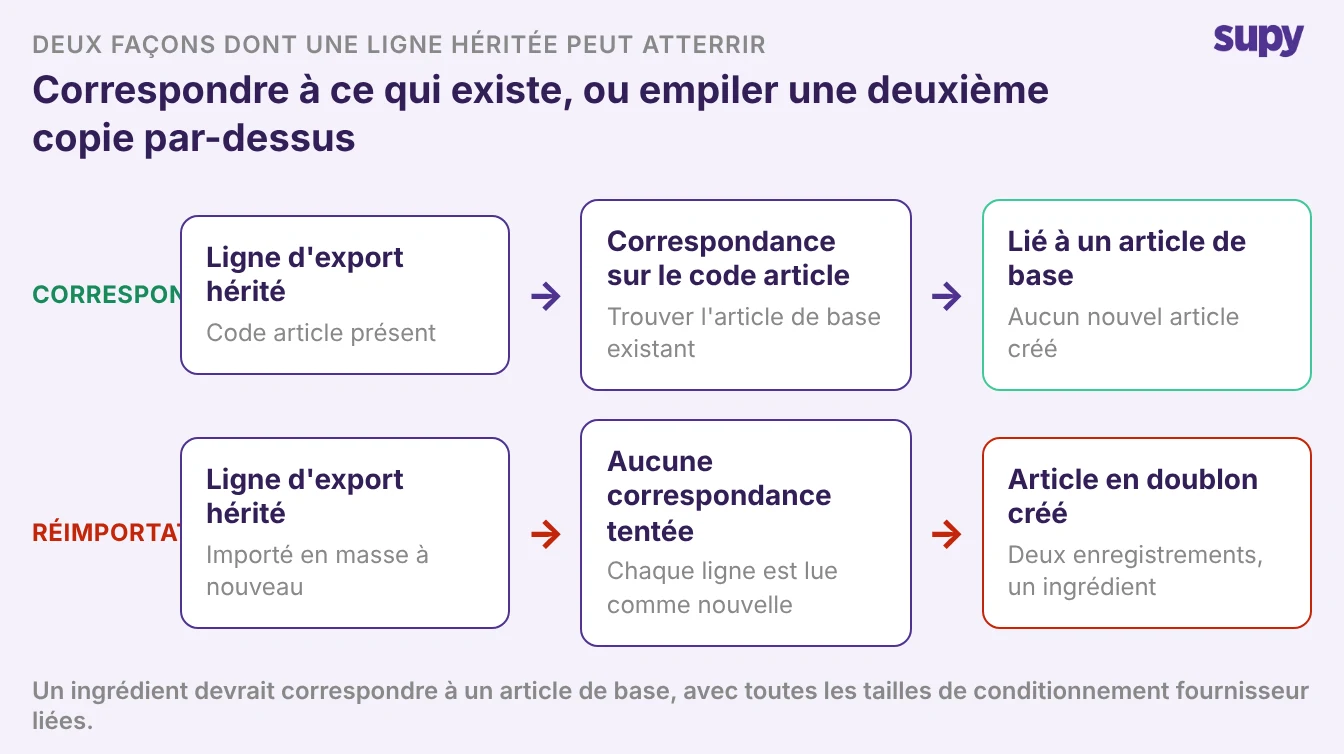
Flux de traitement montrant une ligne d'article hérité correspondant sur le code article à un article de base existant, avec une ligne non correspondante acheminée vers la révision plutôt que de créer un doublon

Nettoyez l'export avant qu'il n'atteigne le modèle d'importation

La plupart des problèmes de doublons commencent dans l'export, pas lors de l'importation. Les exports hérités arrivent souvent sans les codes articles nécessaires pour la correspondance, ou dans un format que le modèle d'importation n'acceptera pas. Corrigez le fichier d'abord, puis importez.

Travaillez sur l'export avant qu'il n'approche le modèle. Les quatre problèmes ci-dessous sont à l'origine de la plupart des doublons et des importations rejetées.

Ce que l'export hérité ratePourquoi l'importation échoueCorrigez avant d'importer
Pas de code article sur chaque ligneRien à faire correspondre, donc chaque ligne est lue comme nouvelleAjoutez le code de l'ancien système, ou faites correspondre par nom exact
Deux lignes pour le même ingrédientLes deux sont importées comme des articles de base séparésRegroupez en un seul article de base avec ses tailles de conditionnement
Colonnes de modèle obsolètes ou incorrectesL'importation est rejetée ou mappée sur le mauvais champReconstruisez le fichier sur le modèle actuel
Recettes exportées en texte libreLes ingrédients ne seront pas liés aux articles de baseDivisez en lignes structurées, un ingrédient par ligne

Le fichier de recettes nécessite la même rigueur. Un export de recettes hérité est souvent un long champ texte par plat, donc rien ne lie à un ingrédient. Transformez-le en lignes structurées, un ingrédient par ligne, avant d'essayer de faire correspondre quoi que ce soit.

Décidez ce qui se passe avec les lignes sans correspondance

Certaines lignes ne correspondront pas, et c'est normal. La décision porte sur ce que vous en faites. C'est là que le doublon est soit évité, soit créé.

Envoyez une ligne sans correspondance en révision plutôt que de la laisser créer un nouvel article sur le moment. Lorsqu'un article reçu ne peut pas être mis en correspondance avec une entrée du référentiel existant, Supy le retient dans une file d'approbation en attente plutôt que de bloquer le travail. Quelqu'un passe alors en revue chaque ligne retenue et décide si c'est un véritable nouvel article ou un autre nom pour un article déjà existant.
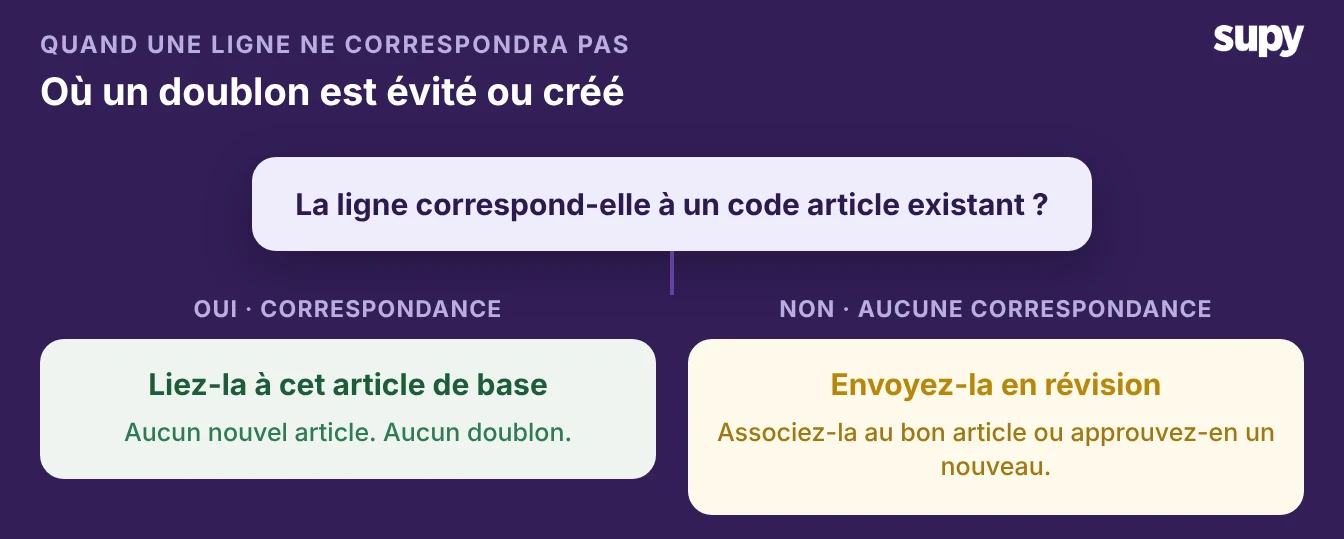
Arbre de décision : si une ligne correspond à un code article existant, liez-la ; si elle ne correspond pas, envoyez-la en révision pour l'associer au bon article de base ou approuver un nouveau

La règle est simple. Si la ligne correspond à un code article existant, liez-la et continuez. Si elle ne correspond pas, elle va en révision. Là, vous l'associez soit au bon article de base, soit vous l'approuvez comme nouveau.

Effectuez un test à blanc avant de toucher aux données réelles

Ne laissez jamais la première importation réelle être la première fois que vous voyez ce qu'elle fait. Exécutez-la une fois sur un lot de test, lisez le rapport de ce qu'elle créerait, et corrigez les mappings avant qu'elle n'atteigne votre référentiel d'articles réel.

Un test à blanc transforme les suppositions en une liste sur laquelle vous pouvez agir. Il vous montre les lignes exactes qui ne correspondront pas, alors que rien n'a encore été créé.
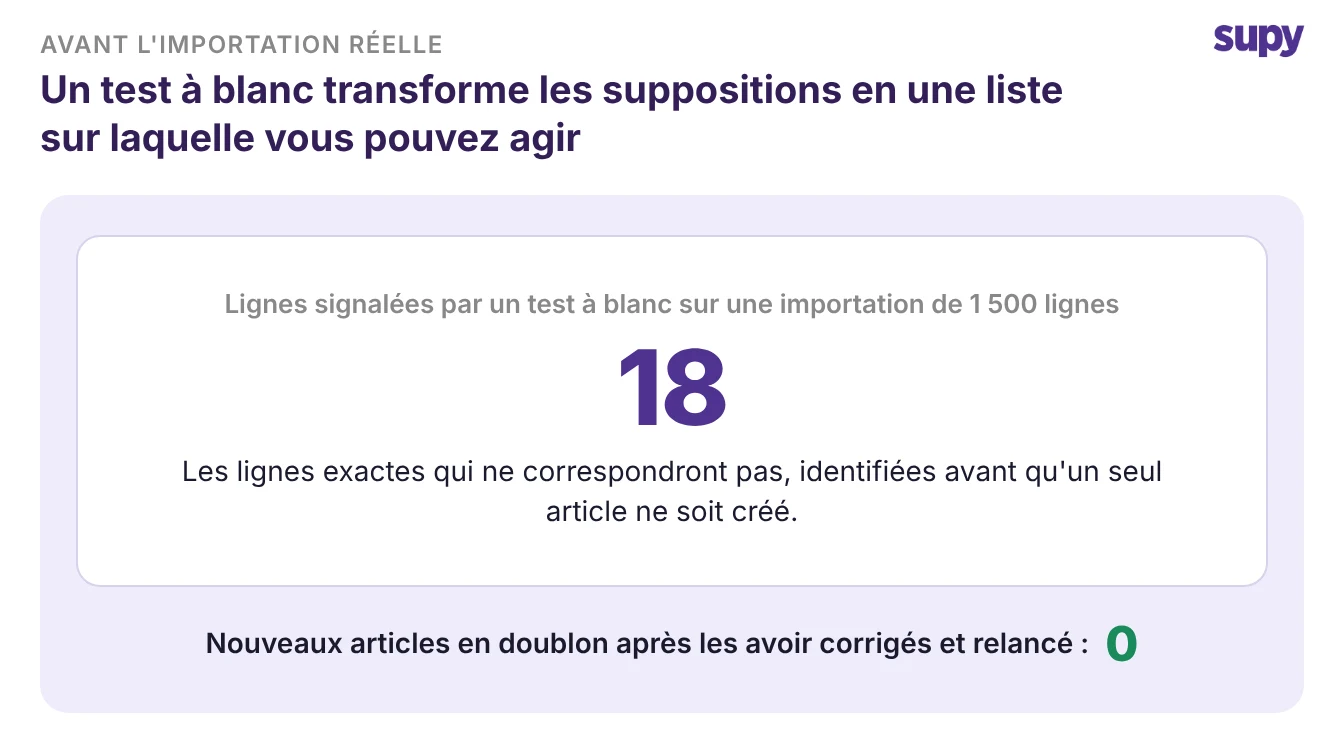
Encart statistique montrant 18 lignes signalées par un test à blanc à corriger avant d'importer 1 500 lignes, afin qu'aucun nouvel article en doublon ne soit créé

Sur une importation de 1 500 lignes, un test à blanc vous indique les 18 lignes qui ne correspondront pas avant qu'un seul nouvel article n'existe. Vous résolvez ces 18 lignes, relancez, et le nombre de nouveaux doublons reste à zéro.

Associez les plats du menu aux recettes pour que les ventes déduisent les bons stocks

Un référentiel d'articles propre n'est que la moitié de la migration. Si le menu n'y est pas connecté, les ventes ne déduiront pas les stocks, et vos chiffres théoriques resteront vides après le lancement.

Une fois les articles chargés, associez chaque plat POS à la recette qu'il vend, ou signalez ceux qui ne nécessitent pas de suivi. Vous pouvez traiter de nombreuses associations à la fois plutôt qu'une par une. Une fois qu'un plat est lié à sa recette, chaque vente déduit automatiquement les bons ingrédients.
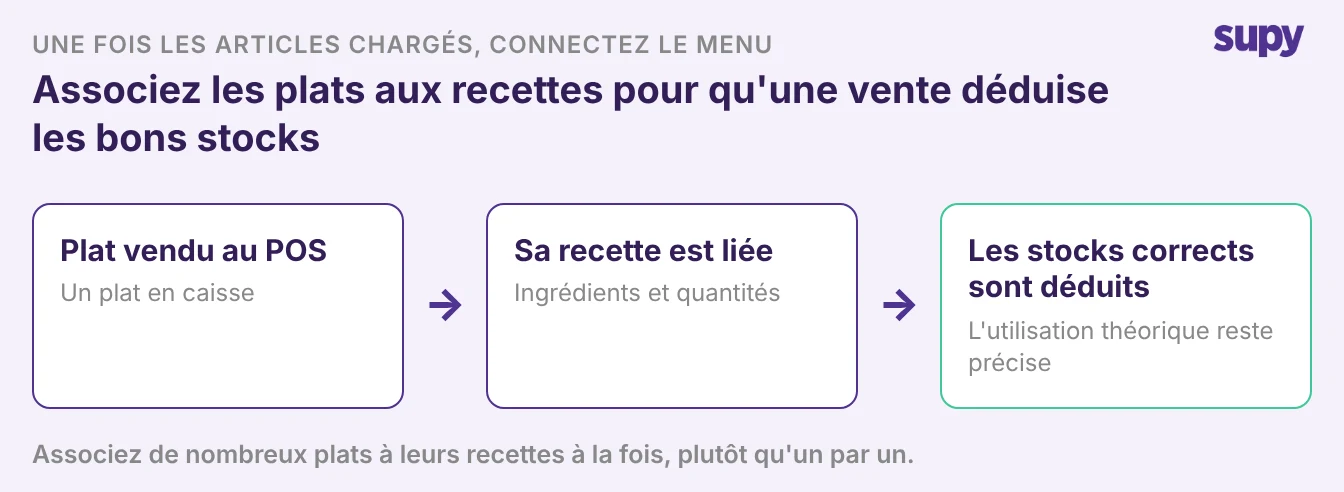
Flux de traitement montrant un plat POS associé à sa recette afin qu'une vente déduise les bons ingrédients des stocks

Une protection supplémentaire maintient la ligne par la suite. Si quelqu'un tente d'enregistrer une configuration de coût en doublon pour la même recette et le même point de vente, Supy le bloque à l'enregistrement. Le référentiel propre que vous venez de créer n'est pas silencieusement défait dans la première semaine.

Commencez par ce que vous migrez réellement. Si votre export hérité a des codes articles, commencez par faire correspondre sur ceux-ci et envoyez uniquement les inadaptés en révision. Si ce n'est pas le cas, consacrez votre premier effort à ajouter des codes ou des noms exacts, car sans eux, chaque ligne sera lue comme nouvelle.

Ne faites jamais une importation réelle en premier. Exécutez le test à blanc, videz la file de révision, et seulement ensuite importez pour de vrai. Faites cela et la taille du fichier cesse d'avoir de l'importance. Vous faites correspondre à ce qui existe déjà, sans empiler une deuxième copie par-dessus.

Réservez une démo avec Supy - migrez les données de stocks de votre restaurant sans doublons

Ready to optimize your restaurant operations?

Blog

Our operational insights

No items found.

Your questions 
answered

Everything you need to know about Supy — from setup to integrations, pricing, and daily use. If it’s not covered here, just ask.

Comment migrer les données d'inventaire sans créer d'articles en double ?
+

Vous rapprochez chaque ligne héritée d'un article déjà existant au lieu de télécharger à nouveau l'intégralité du fichier en masse. Exportez vos articles avec leurs codes article, rapprochez chaque ligne sur ce code, et reliez les conditionnements fournisseur à l'article de base unique auquel ils appartiennent. Ne créez un nouvel article que lorsque rien ne correspond, et envoyez tout ce qui est incertain en révision d'abord. Les doublons proviennent presque toujours du rechargement des lignes que vous pensez manquantes, donc rapprocher ce qui est déjà là est l'habitude qui les prévient.

Pourquoi un second import en masse crée-t-il des articles en double ?
+

Parce qu'un import en masse ne vérifie pas ce qui existe déjà. Lorsque vous importez un fichier pour compléter les articles que vous pensez manquants, le système traite chaque ligne comme nouvelle à moins de pouvoir la rapprocher. Si le fichier n'a pas de codes article, ou si les noms diffèrent même légèrement de ceux déjà chargés, chaque ligne devient son propre article de base. Vous vous retrouvez avec deux enregistrements pour un seul ingrédient. La solution consiste à rapprocher avant de charger, et à ajouter des codes article ou des noms exacts pour que le système reconnaisse les articles que vous avez déjà.

Que faire des articles hérités sans code article ?
+

Ajoutez d'abord le code de votre ancien système partout où vous le pouvez, car c'est ce qu'il y a de plus propre à rapprocher. Là où il n'existe pas de code, rapprochez-vous plutôt du nom exact de l'article, et standardisez ces noms avant l'import pour que les petites différences ne soient pas lues comme de nouveaux articles. Tout ce qui ne peut toujours pas être rapproché devrait aller dans une file d'attente de révision plutôt que directement dans le référentiel. Là, quelqu'un confirme si la ligne est véritablement nouvelle ou un autre nom d'un article que vous avez déjà, de sorte qu'un code manquant ne devienne jamais silencieusement un doublon.

Que se passe-t-il avec une ligne qui ne correspond pas à un article existant ?
+

Lorsqu'une ligne ne peut pas être rapprochée d'une entrée existante, elle est mise en attente pour révision au lieu de bloquer l'import ou de créer un article de façon autonome. Quelqu'un ouvre chaque ligne en attente et prend une décision : la pointer vers l'article de base auquel elle appartient réellement, ou l'approuver en tant que nouvel article authentique. C'est l'étape qui maintient le référentiel propre, car les lignes risquées sont celles qui ne correspondent pas. Les traiter manuellement un moment est bien moins coûteux que de fusionner des doublons sur tous les sites par la suite.

Une migration peut-elle fusionner des articles déjà en double dans mon système ?
+

Non. Les contrôles d'une bonne migration empêchent les nouveaux doublons ; ils ne nettoient pas ceux que vous avez déjà. Le rapprochement avec les articles existants, la mise en attente des lignes non concordantes pour révision et le blocage d'une configuration de coût dupliquée à l'enregistrement empêchent tous la création d'un second exemplaire. Ils ne fusionnent pas deux enregistrements déjà actifs. Si votre référentiel actuel contient déjà des doublons, traitez cela comme un nettoyage séparé avant ou après la migration, et utilisez la migration elle-même pour vous assurer que vous n'en ajoutez pas d'autres lors de l'import.

Combien de temps prend une migration de référentiel d'articles ?
+

Cela dépend bien plus de la qualité de votre export que du nombre d'articles que vous avez. Un fichier avec des codes article, une ligne par ingrédient et les bonnes colonnes de modèle s'importe rapidement, car la plupart des lignes correspondent d'elles-mêmes. Un fichier sans codes, rempli de lignes en double ou exporté en texte libre prend plus de temps, car vous devez le corriger avant qu'il ne se charge. Prévoyez du temps pour un essai à blanc et pour vider la file d'attente de révision. Ces deux étapes prennent un peu de temps au début et permettent d'éviter bien plus de corrections après le lancement.

Pourquoi associer les articles du menu aux recettes lors d'une migration d'inventaire ?
+

Parce qu'un référentiel d'articles propre ne suit le stock que si les ventes le réduisent réellement. Une fois vos articles intégrés, associez chaque article de menu POS à la recette qu'il vend, ou marquez ceux qui n'ont pas besoin de suivi. Vous pouvez traiter plusieurs de ces associations à la fois plutôt qu'une par une. Une fois un plat lié à sa recette, chaque vente déduit automatiquement les bons ingrédients, et votre utilisation théorique et vos écarts commencent à se remplir dès le premier jour au lieu de rester vides après le lancement.

Êtes-vous prêt à transformer vos opérations ?

Comme plus de 5 000 restaurateurs utilisez Supy pour réduire vos coûts, rationaliser les opérations et prendre des décisions plus intelligentes.